
一般来说,我们从数据库中获得的数据都是真实可靠的。然而,经过分组、统计计算和通过图表呈现后,最终可能会得出不可靠的结论。
曾经也有一个leader和我说:“数据具有欺骗性,你需要相信数据,但也不能全信数据。”
1.辛普森悖论
E.英国统计学家h·辛普森(H.Simpson)在1951年首先解释了一种现象,即一种趋势出现在几组不同的数据中,但当这些组组合在一起时就消失或逆转了。并且他将这种反常现象命名为“辛普森悖论”。
比如一款游戏在Android设备上的整体留存率高于iOS设备。然而,如果我们把设备进一步细分为手机和平板,可能会发现iOS设备在每个细分市场的留存率都高于Android设备。这种现象的深层逻辑往往是某些内在因素在不同分组中的分布不均。平板设备本身的游戏留存率可能较低,而Android设备中平板的比例明显低于iOS,这就导致了整体数据的趋势被逆转。
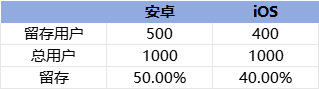
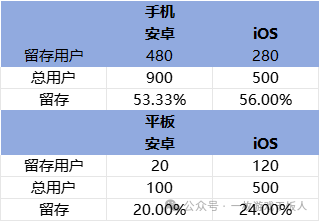
这种情况就符合辛普森悖论。
首先是找出内在逻辑。比如上一个问题,深层逻辑可能是平板本身的游戏留存率低。但Android设备中平板的占比明显低于iOS,移动设备以Android为主,最终导致了辛普森悖论。所以在考虑问题的时候,一定要理清逻辑,明确核心点是什么,避免在按照某个指标拆分或合并统计的同时随意进行数据统计。
二是设置权重。可以设置实验对照组,需要保证不同组中各组分的比例大体一致,从而在一定程度上减少甚至消除辛普森悖论的影响。总之,在游戏数据分析的过程中,如果要研究一些不同受众或不同设备的游戏,测量一些指标,就要警惕辛普森悖论的存在。
2.相关问题
在分析指标相关性时,往往有两个看似完全不相关的指标,很可能表现出很高的相关性。一般来说,相关性和因果性有三种关系。
-
因果关系:在某些情况下,两个变量之间确实存在直接的因果关系。比如A影响B,或者B影响A。这种关系可能是直接的,也可能通过一系列步骤建立。为了证明这种因果关系,我们需要进行细致的分析,验证每一步。
-
共同因素干扰:有时候,两个变量看似相关,但实际上并没有直接的因果关系,而是受到一个第三方因素的影响。比如,夏天人们吃冰淇淋的数量增加,同时游泳池的使用频率也上升。这里,天气(夏季)就是共同因素,它促使两个变量的变化。
-
随机关系:此外,有时候这两个变量的相关性可能只是偶然的结果。这种情况造成的相关性没有实际意义,纯粹是由于随机因素的影响。
相关性只能作为潜在因果关系的提示,而不能直接说明一个变量导致了另一个变量的变化。在进行数据分析时,尤其是在游戏归因分析时,我们需要对相关性表现出审慎的态度。需要深入理解游戏的机制及玩家行为,以便更好地判断其中的变量间是否真的存在因果关系。
如果在研究中发现两个变量之间的相关性较高,我们应该进一步分析,寻找可能的因果关系,或考虑是否有共同因素的干扰。如果我们只是依据相关性做出结论,可能会导致错误的推断,影响决策和策略制定。因此,在数据分析的过程中,理解变量之间的关系是至关重要的。
举个例子:分析哪些因素会影响玩家在游戏中的付费金额。
-
变量A:玩家每天玩游戏的时长
-
变量B:玩家每月的付费金额
经过分析,你发现玩家每天玩游戏的时长(变量A)和他们的每月付费金额(变量B)之间的相关系数为0.75(1表示完全正相关)。这表明两者之间存在较强的正相关性,似乎玩游戏时间越长,付费金额越高。仅仅基于这个相关性,你可能会得出以下初步结论:“增加玩家每天玩游戏的时长可以提高他们的付费金额。”可能存在一个第三方因素C,同时影响了玩家玩游戏的时长和他们的付费金额。
比如变量C:玩家对游戏的喜爱程度。
那些非常喜欢这款游戏的玩家,既会花更多时间玩游戏(变量A),也更愿意在游戏中付费(变量B)。这里,玩家对游戏的喜爱程度(变量C)同时影响了玩游戏的时长和付费金额,而不是简单的“玩得久就付费多”。
或者在某些情况下,相关性可能只是随机波动的结果。比如在某个特定时间段,如周末/假期,玩家可能有更多空闲时间玩游戏,同时也有闲钱进行付费。这种相关性并不具有长期稳定性,不能作为制定策略的依据。
3.图表呈现的误导
异常值处理不当:如果图中有些数值与平均值差距很大,直接画出来的曲线可能会让人看不清整体趋势。解决办法是把这些异常值用其他符号表示,或者调整坐标轴的范围。
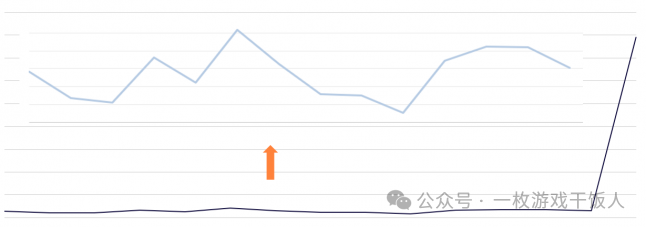
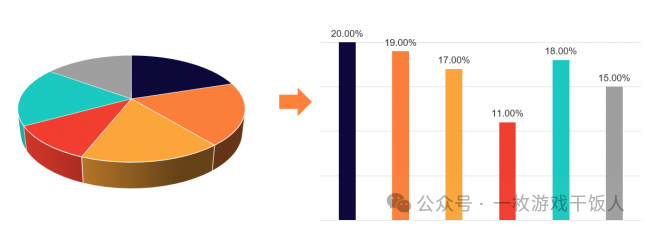
3D图形的视觉陷阱:比如3D饼状图,最靠近观众的部分看起来会比实际大,因为我们的眼睛会觉得近的东西更大。这种图表容易让人误解数据的真实比例。
截断坐标轴:有时图表的坐标轴不是从0开始,这样会让人感觉两个数据点的差距比实际大,只为了突出某个数据点。
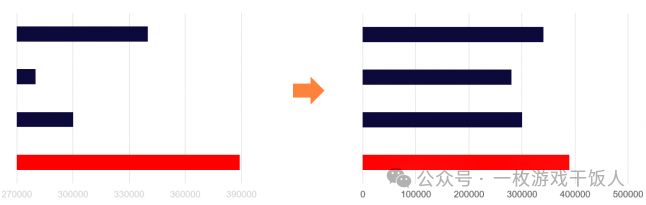 从数据分析者的角度来看,既要显示正确的数据,也要正确地显示数据。尽量避免使用太容易导致误解的3D图形;从阅读者的角度来看,要注意图形的内容元素,不要陷入视觉陷阱。
欢迎阅读笔者其他内容
未经授权请勿用于任何商业用途



发表评论