现在很多资深AI用户,手头基本都常备好几套工具,Cursor内置Claude、Kiro反代额度、曾经的20x无限免费bug版本,轮番切换使用。大家折腾这么多,没有别的复杂原因,纯粹是Claude的产品力太能打,用着省心、效率碾压。哪怕账号容易被封,大家被封了也会重新注册接着用,这就是最真实的口碑。

用过GPT、各类国产大模型再换回Claude的人,都会有一个统一感受,别的模型上限不一定低,但下限很飘;Claude或许不是最强天花板,但稳定性绝对是T0级别。GPT的通用能力确实全面、生态成熟,日常闲聊、简单创作体验很好,但最大的硬伤是频繁降智、发挥不稳定。有时候思路清晰、回答精准,有时候又漏洞百出、逻辑掉线,完全看运气,让人非常无奈。Claude还有体验同样扎实的国产K3模型,主打一个稳如老狗。输出质量始终在线,不会突然掉线降智,能稳稳接住各类复杂任务,不用用户反复纠错、兜底。尤其是Opus 5.5版本更新后,Claude的综合实力直接拉满,唯一的短板只剩偶尔会封号,几乎没有其他缺点。
真正拉开模型差距的,是代码开发、复杂工程迭代这类硬核场景,两者的表现可以说是天差地别,核心差距集中在两点。
Claude最大的优势,是能自主识别工程约束、理解任务核心,还会主动清理冗余内容。日常开发中,你直接丢一个模糊需求,比如“帮我优化一下这个项目的性能”,它不需要你细化指令,就能自己排查问题、找到优化方向、改写代码,同时主动删掉老旧、低效、无用的旧代码,避免项目堆积垃圾。它的代码逻辑清晰、复杂度可控,返工率极低。交给它的任务,从分析、改代码、跑测试到自查bug,能一套流程做到底,不用用户全程盯着、反复叮嘱,是真正可以放心交付的AI助手。
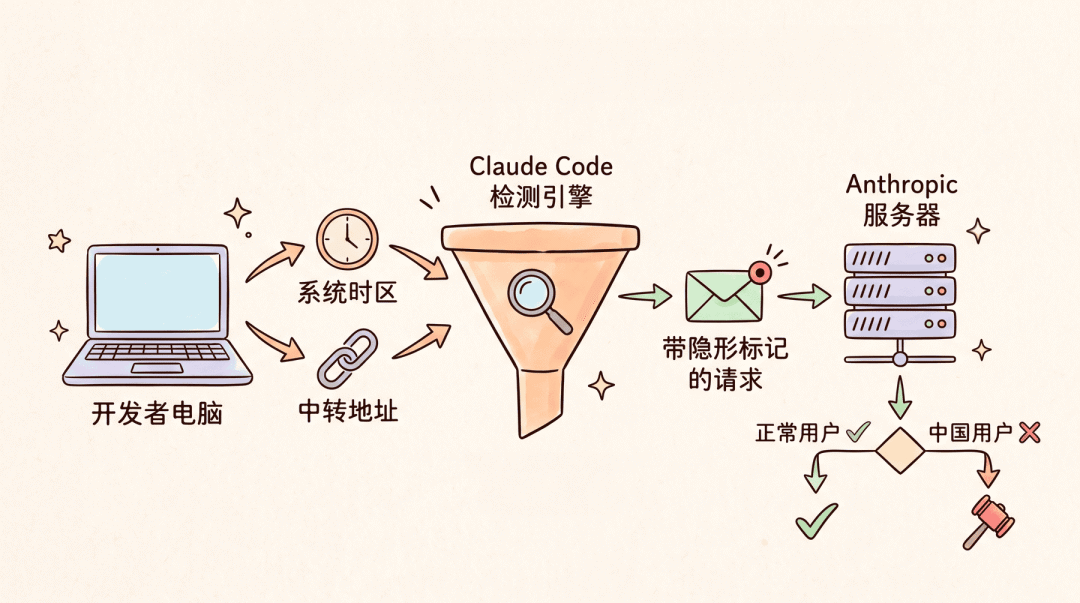
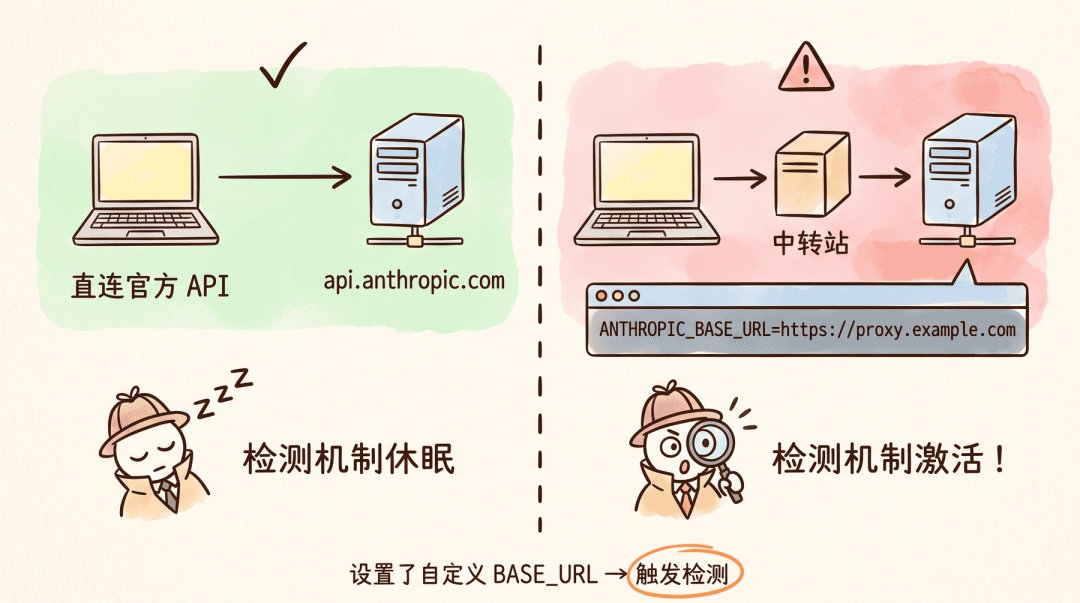
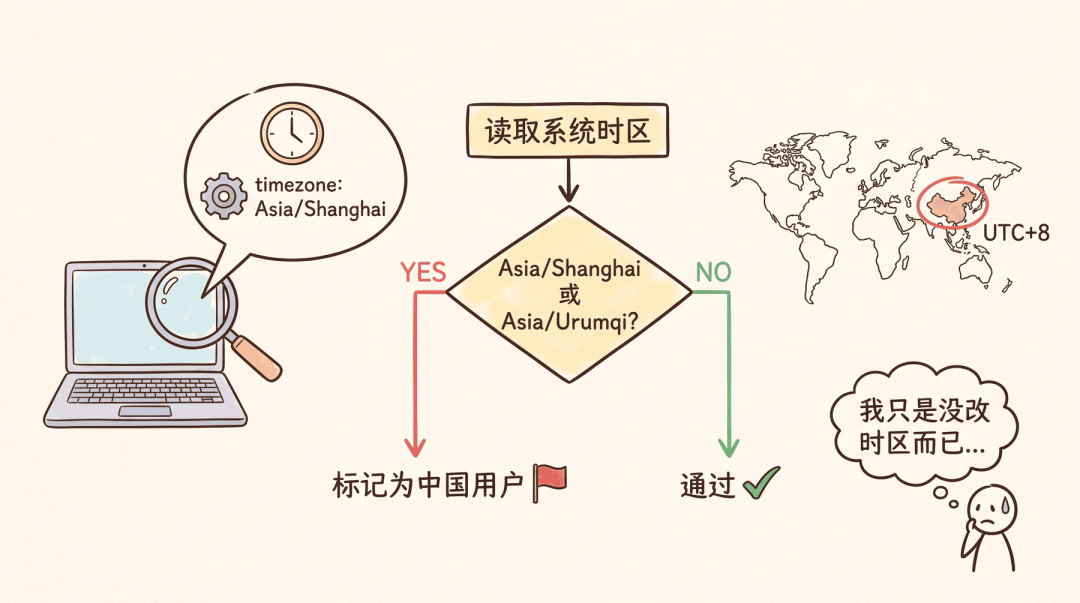
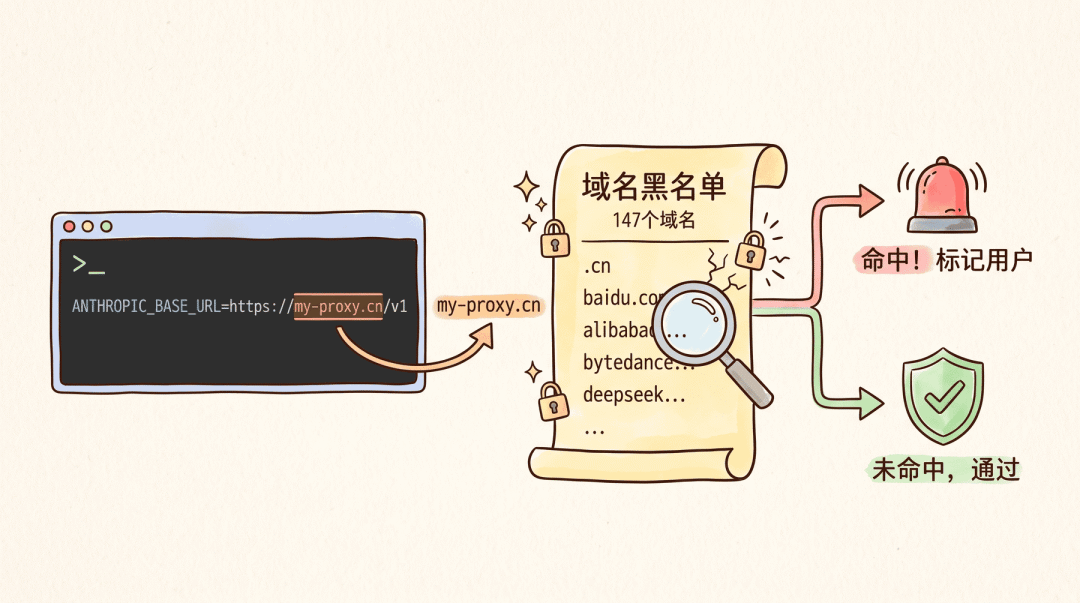
为啥要封号呢?
GPT在编码上有两个改不掉的硬缺陷,即便最新的Astra版本有所改善,依旧不够好用,而且付费成本极高。第一是过度保守,沉迷冗余防御性编程。为了保证绝对不出错,它会堆砌大量兜底逻辑、无效测试和多余的备用代码。最致命的问题是:它只会新增代码,绝不主动删除旧代码。只要用户没有明确说删掉无用部分,它就会一直叠加内容,久而久之项目直接变成难以维护的屎山代码,后期清理成本极高。第二是忽略项目约束,极易返工。GPT的训练逻辑是为了节省token、提升推理效率,导致它经常忽略项目整体规则和细节约束。一旦用户的提示词不够精准,它改完功能大概率会引发新bug,测试全线崩盘,每次使用都需要用户极致细化指令,容错率极低。
单看单次问答,很多模型的回答质量都不差,几乎看不出区别。但只要跑一次长时间、多步骤、高复杂度的连续任务,差距瞬间拉开。
很多模型干活的通病,做着做着就跑偏、擅自额外加戏、看似产出很多,实则漏洞百出,最后还要用户花更多时间收拾烂摊子。Claude的优势就是听话、靠谱、执行力稳定。你明确告知哪些内容别动、只改哪些模块、先分析再动手,它基本能严格遵守规则执行。全程稳步推进任务,不跑偏、不瞎加内容、不无效堆叠,真正做到交给它就能做完、做好。在AI Agent自主干活的场景里,Claude是少有的能让人放心放权、不用全程盯守的模型。
可能没人是Claude的死忠粉,我所了解到的情况是大家只是纯纯的实用主义买单,用真金白银投票。对于长期重度用户,Claude+的API价格对比同级模型,堪称白菜价,低成本就能拿到顶级生产力。普通模型需要100步反复调试、纠错、清理垃圾的工作,Claude可能10步就能搞定,大幅减少试错和善后成本。
用过顶级模型后,很难再忍受普通模型的迟钝、反复出错、听不懂指令,反复纠错非常消耗心态。
目前国产模型,无论免费还是订阅付费版本,没有任何一款能追上OpenAI和Anthropic的帕累托前沿。Deepseek等模型价格依旧偏高,对想法多、需求复杂的用户来说,完全不划算。稳定性、执行力、自主优化能力全方位领先,适合真正落地干活,而非单纯闲聊娱乐。
普通用户选AI,无非两个原则,而且两者完全不冲突:
第一是免费优先、够用就好:日常闲聊、简单文案、轻度使用,免费模型完全能满足需求,没必要额外花钱。
第二是体验优先、省心为王:重度工作、复杂编码、长期项目迭代,坚决选Claude。
所有AI模型都能用、都能做完工作,但体感天差地别。便宜模型不是不能用,而是需要你全程紧盯、反复修正、花费大量时间善后。本质就是用钱买时间、买心态,你觉得自己的时间值钱、不想被AI反复折腾,就会毫不犹豫选Claude。
模型迭代一直轮换,Claude 4.7、4.8翻车时,大批用户转投Codex;GPT 6口碑崩盘后,大家又集体回归Opus 5.5。没有永恒的强者,只有永恒的实用主义。谁稳定、谁省心、谁效率高,用户就用谁,仅此而已。
未经授权请勿用于任何商业用途



发表评论